
Un nouvel ERP peut être installé dans les délais et pourtant laisser les équipes bloquées dès le lendemain. Il suffit que les historiques de commandes arrivent sans leurs clients, que des champs métier disparaissent ou que des factures soient comptées deux fois.
Dans un projet de migration de données, le transfert technique n’est qu’une partie du travail : il faut préserver le sens des informations, leurs liens et leur utilité dans le système cible.
Un cadre de migration solide commence par l’examen de l’existant, puis encadre la cartographie des données, leur préparation, les tests de migration et la validation métier.
Le choix des outils de migration vient ensuite. Un ETL ou une réplication bien configurée ne rattrapera pas des règles de correspondance mal définies. À l’inverse, une méthode claire permet de repérer les écarts avant qu’ils ne deviennent des incidents de production.
Prenons l’exemple d’une PME qui remplace son logiciel commercial sans pouvoir interrompre la prise de commandes. Son équipe doit transférer clients, devis, commandes et historiques, tout en protégeant les données personnelles.
Le fil conducteur est simple : mesurer, transformer, contrôler, puis basculer. L’ancien système reste disponible jusqu’à ce que les utilisateurs aient vérifié les informations dont ils se servent au quotidien.
En bref
- Auditer les sources et décider quelles données conserver, archiver ou écarter.
- Documenter les correspondances et transformations dans la cartographie des données.
- Nettoyer, tester sur un échantillon, puis comparer les résultats avec des règles métier.
- Garder l’ancien système jusqu’à validation et prévoir une procédure de retour arrière.
- Choisir entre bascule planifiée et synchronisation CDC selon la tolérance à l’interruption.
Un cadre de migration adapté aux données et au métier
Une migration de données transfère des informations d’un système source vers un système cible. Elle concerne aussi bien le remplacement d’un CRM que le passage d’une base auto-hébergée à un service managé, la fusion de référentiels ou le déplacement de documents vers un nouvel espace de stockage.
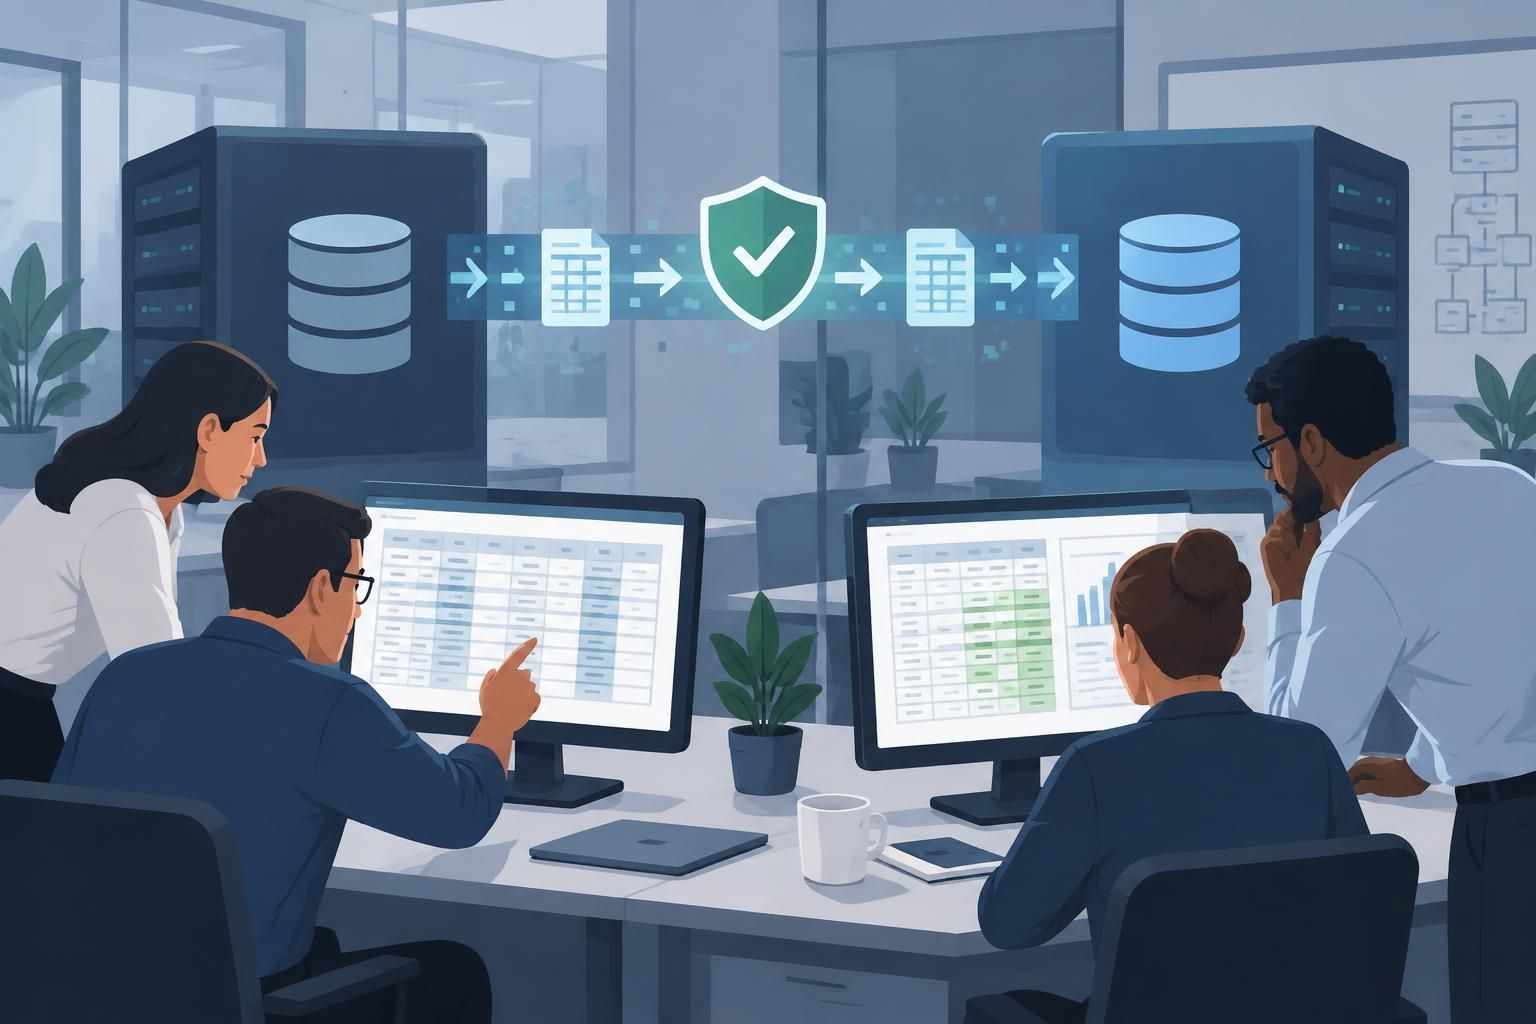
Le déplacement brut est rarement suffisant. Les structures diffèrent : un ancien logiciel peut stocker le nom complet dans un champ, quand le nouveau sépare prénom et nom. Des identifiants changent, des statuts sont renommés et certaines relations entre clients, commandes et factures doivent être reconstituées. Le travail consiste donc à transférer les données sans perdre leur logique métier.
Le cadre de migration doit préciser le périmètre, les responsabilités, les critères d’acceptation et les décisions de conservation. Une donnée inactive depuis plusieurs années n’a pas forcément à rejoindre la nouvelle application. L’archiver peut réduire le volume, les coûts et le nombre de cas atypiques à tester, à condition de respecter les obligations de conservation applicables.
Dans une migration applicative, les arbitrages métier sont souvent plus délicats que les conversions de formats. Un champ « potentiel » utilisé par les commerciaux peut ne pas exister dans le modèle cible. L’équipe doit alors décider s’il devient un champ personnalisé, une catégorie ou une information d’archive. Le choix doit être validé par les personnes qui exploiteront réellement le nouvel outil.
Un changement de CMS suit la même logique : contenus, comptes, catégories, URL et pièces jointes ne se déplacent pas toujours à l’identique. Pour comparer les modèles de contenu avant de choisir une cible, le comparatif entre Drupal et Joomla donne des repères utiles sur leurs différences de fonctionnement.
Audit, cartographie et qualité des données avant le transfert
La planification commence par un audit technique et fonctionnel. Il faut inventorier les sources, les volumes, les formats, les champs vides, les doublons et les dépendances. Un profilage SQL ou un outil spécialisé peut révéler des anomalies, mais les utilisateurs métier savent souvent expliquer pourquoi un champ apparemment inutilisé reste indispensable à une équipe.
La cartographie des données décrit, champ par champ, la source, la cible, la règle de transformation et le traitement des exceptions. Elle couvre aussi les relations entre entités et les règles d’identification. Pour les dates, par exemple, le projet doit fixer le fuseau horaire et le format attendus. Pour les clients, il doit définir comment reconnaître un doublon lorsque les raisons sociales sont écrites différemment.
Une cartographie exploitable ne se limite pas à un tableau de noms de colonnes. Elle indique qui a validé les règles, quelles valeurs sont exclues et comment les erreurs seront consignées. Sans cette documentation, deux développeurs peuvent interpréter différemment un même statut ou corriger les données de façon contradictoire.
Le nettoyage améliore la qualité des données avant leur arrivée dans la cible : normalisation des dates et adresses, déduplication, correction des valeurs incohérentes. L’automatisation convient aux règles déterministes. En revanche, une correspondance ambiguë entre deux contacts doit passer par une validation humaine plutôt que par une fusion hasardeuse.
Des scripts SQL suffisent parfois pour une base simple. OpenRefine peut aider à explorer et nettoyer des fichiers tabulaires, tandis que des plateformes de qualité ou d’intégration répondent mieux à des volumes et à des flux complexes. Le catalogue d’outils de développement web peut aussi servir de point de départ pour organiser les outils et pratiques autour d’un projet technique.
Tests de migration et contrôles qui prouvent le résultat
Avant la bascule générale, une migration pilote doit porter sur un échantillon représentatif, pas seulement sur les dossiers les plus simples. Il faut inclure des enregistrements anciens, des cas incomplets, plusieurs statuts et des relations entre objets. Cette répétition permet de mesurer la durée réelle du transfert et de corriger les règles avant que l’ensemble des utilisateurs soit concerné.
Les tests de migration vérifient plusieurs niveaux. Le comptage compare les volumes source et cible ; les contrôles référentiels confirment que chaque commande pointe vers le bon client ; les vérifications métier comparent, par exemple, les totaux de facturation ou le nombre de dossiers ouverts. Un nombre identique d’enregistrements ne prouve pas que les données sont correctes.
| Contrôle | Ce qu’il vérifie | Exemple |
|---|---|---|
| Comptage | Présence des enregistrements transférés | Nombre de clients actifs par rapport à la source |
| Intégrité | Conservation des liens entre les données | Commandes rattachées à un client existant |
| Cohérence métier | Conformité des valeurs et calculs | Somme des factures par période |
| Validation utilisateur | Exploitation réelle dans le nouvel outil | Recherche d’un dossier et consultation de son historique |
Les écarts doivent être consignés avec leur cause, leur gravité et leur décision de traitement. Dans un cas fréquent, les commandes en attente sont oubliées parce que la requête d’extraction ne sélectionne que les commandes clôturées. Un test métier ciblé révèle l’omission avant la mise en service ; un simple contrôle de volume peut, lui, ne pas suffire à la détecter.
Les outils ETL ou ELT automatisent l’extraction, la transformation et le chargement. Ils sont utiles pour appliquer des règles reproductibles, mais ne remplacent ni les scénarios de test ni l’approbation des équipes. Une feuille de calcul peut convenir à un petit transfert ; elle devient vite fragile quand les volumes, les exceptions et les reprises se multiplient.
Sécurité des données, risques et stratégie de bascule
La gestion des risques doit couvrir la perte, la corruption, les doublons, les interruptions et l’exposition d’informations sensibles. Une sauvegarde complète de la source est nécessaire, mais elle ne protège que si sa restauration a été testée. La conserver sans vérifier qu’elle est exploitable revient à garder une clé dont on n’a jamais essayé la serrure.
La sécurité des données exige des transferts chiffrés, des accès limités aux personnes concernées et une traçabilité des opérations. Dès que des données personnelles sont traitées, le projet doit intégrer les obligations du RGPD, notamment la limitation des accès et la maîtrise des copies temporaires. Les journaux de migration doivent aider à diagnostiquer les erreurs sans exposer inutilement des données sensibles.
La bascule « big bang » transfère les données pendant une fenêtre définie, puis ouvre le système cible. Elle convient si une interruption courte est acceptable et si les dépendances sont maîtrisées. Son avantage est la simplicité de séquencement ; son défaut est qu’une anomalie importante peut imposer un retour rapide à la source.
Quand l’activité ne peut pas s’arrêter, la capture des changements, ou CDC, réplique les modifications effectuées sur la source vers la cible. L’équipe réalise d’abord le chargement initial, puis applique les changements incrémentaux et contrôle les écarts avant de basculer. Cette méthode demande une configuration et une surveillance rigoureuses ; elle ne supprime pas les validations métier.
Le CDC évite la double saisie si la règle de fonctionnement est claire : pendant la synchronisation, la source reste le système de référence jusqu’au moment convenu. Après bascule, les écritures doivent se faire dans la cible. Faire écrire les deux systèmes sans mécanisme de résolution des conflits crée une nouvelle catégorie de problèmes, pas une sécurité supplémentaire.
Validation finale et maintien d’un retour arrière
Le décommissionnement ne doit intervenir qu’après la validation formelle des contrôles techniques et des essais utilisateurs. Les équipes doivent pouvoir retrouver les dossiers, consulter les historiques et réaliser leurs opérations habituelles. Pour une PME, cette validation gagne à s’appuyer sur quelques scénarios quotidiens précis plutôt que sur un accord général donné après une démonstration.
Le plan de bascule précise l’ordre des opérations, les responsables, les horaires, les critères d’arrêt et la procédure de retour arrière. Il indique aussi combien de temps l’ancien système reste accessible en lecture. Cette période évite de transformer un incident corrigible en perte définitive, surtout lorsque des documents ou des cas rares n’apparaissent qu’après la mise en production.
Une migration réussie se juge donc à la capacité des équipes à travailler avec des données complètes, compréhensibles et correctement reliées. Le transfert n’est qu’un événement technique ; la validation est la preuve que le changement tient dans les usages réels. Pour le système source, la consigne reste simple : ne pas le supprimer tant que cette preuve n’existe pas.
Quelles sont les étapes d’une migration de données ?
Le processus comprend l’audit et le profilage, la cartographie des champs, le nettoyage, une migration pilote, le transfert avec contrôles, puis la validation métier. L’ancien système reste disponible jusqu’à l’acceptation de la cible.
Comment migrer sans interrompre l’activité ?
Une approche CDC charge d’abord les données existantes, puis réplique les changements récents de la source vers la cible. La bascule intervient après contrôle des écarts. Elle nécessite de définir clairement quel système reçoit les écritures à chaque phase.
Quels outils de migration choisir ?
Le choix dépend du volume et de la complexité : ETL ou ELT pour transformer et charger, outils CDC pour répliquer les changements, solutions de profilage pour évaluer la qualité, et outils natifs pour les imports simples. La cartographie et les tests restent indispensables quel que soit l’outil.
Comment vérifier que les données sont correctement migrées ?
Comparez les volumes, contrôlez les relations entre enregistrements, vérifiez des règles métier comme les totaux comptables et faites tester les parcours courants par les utilisateurs. Documentez les écarts et obtenez une validation avant le décommissionnement.
